Google GeminiとマルチモーダルAIの根本的な問い――私たちは実際に何を見ているのか
Google Geminiを例に、マルチモーダルAIへ何が入力され、どう変換され、どの情報源が回答を形づくり、誰が主張に責任を負うのかを考えます。
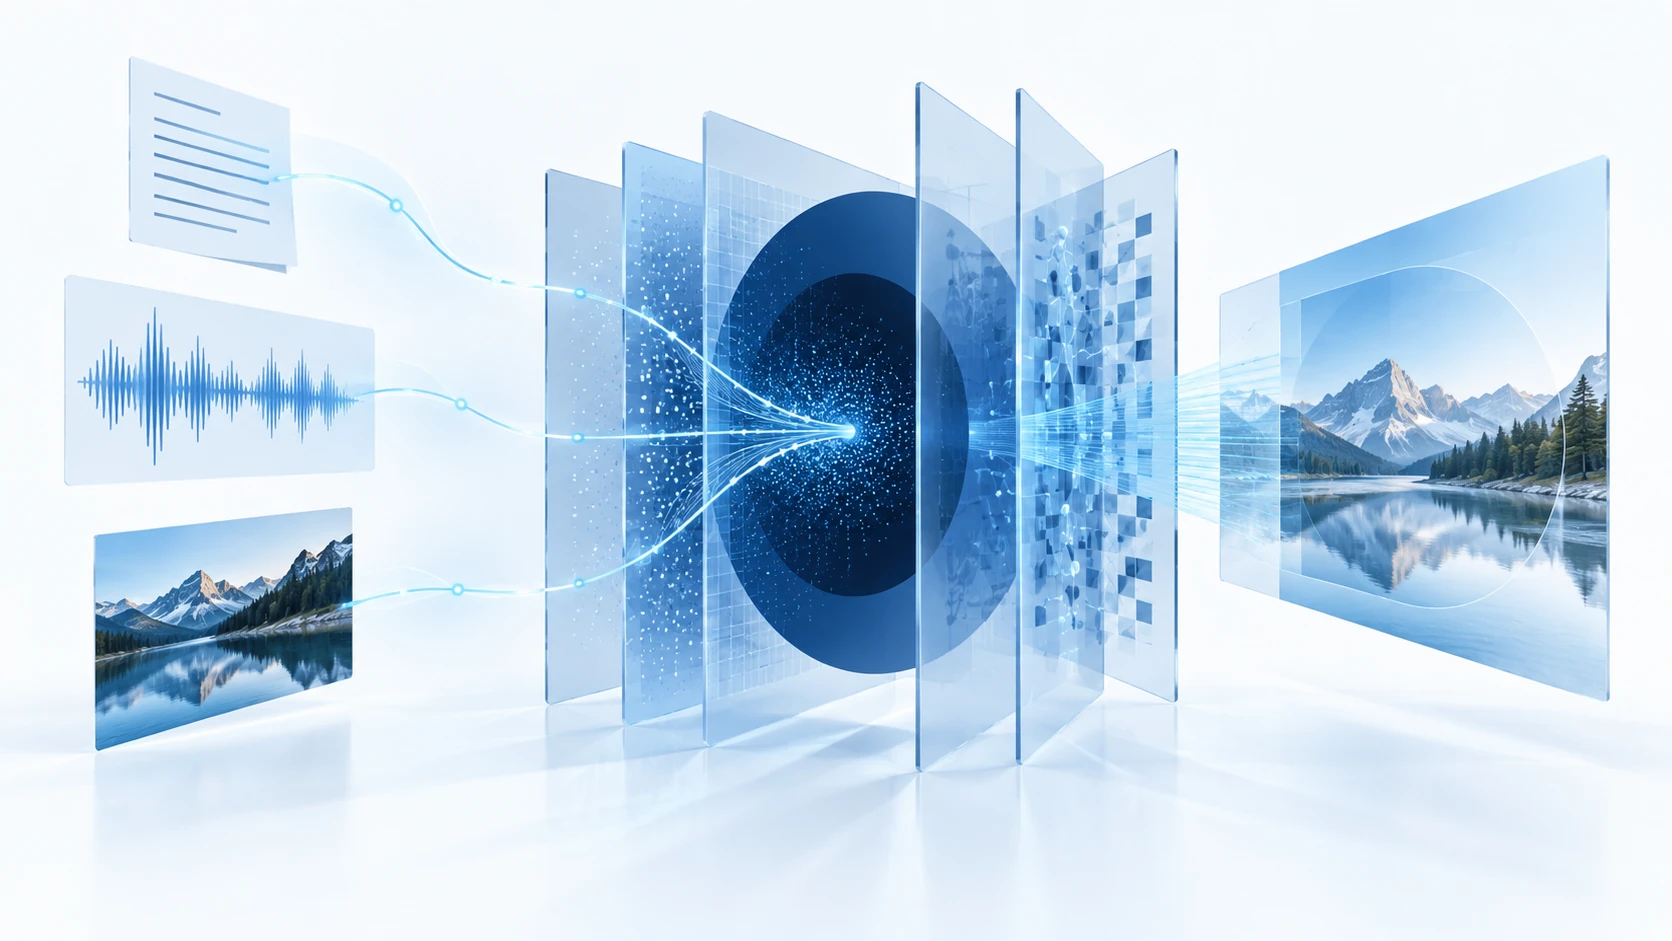
Google Geminiはしばしば、規模を競う物語として紹介される。より新しいモデル、より多くのモダリティ、より多くの製品、そしてGoogleのより大きな野心、という具合だ。しかし、この枠組みでは、マルチモーダルなアシスタントを信頼する前に読者が問うべきことが抜け落ちる。テキスト、画像、音声が同じシステムへ入るとき、私は実際に何を見せられているのか。そして、何が画面の外に残されているのか。
Geminiは、対話型インターフェース、検索企業、巨大なアカウントのエコシステム、異なる種類の入力を扱うよう設計されたモデルが交わる位置にあるため、考察に適した事例である。製品名や機能は変わるだろう。しかし、入力、情報源、変換、責任について明確な説明を求める読者の必要性は変わらない。
本稿は恒久的な機能一覧ではない。マルチモーダルなアシスタントが何をし、その流暢さがどこで人を誤らせうるのか、そして主張の主導権を人に残すにはどうすればよいかを理解するための手引きである。
Google Geminiとは何か
Geminiは、Googleの生成AIモデル群とアシスタント体験の総称である。利用者は説明を求めたり、画像について質問したり、文書を扱ったり、一度のやり取りで複数の形式の資料を組み合わせたりできる。システムは、学習したパターンと、その文脈で利用可能な情報源やツールから応答を生成する。
モデル名だけでは、どのバージョンが答えたか、どの情報にアクセスできたか、情報源が検索されたか、回答が届くまでにどんな変換が行われたかは分からない。これらは技術的な飾りではなく、回答の意味を構成する要素である。
一つのシステムが複数種の入力を扱うと、何が変わるのか
画像は解釈になる
アシスタントに写真の説明を求めても、手つかずの光景がそのまま渡されるわけではない。システムは認識できたものを選び、欠けた部分を言葉で補い、学習した分類を通じて説明する。自信に満ちた説明でも、最も重要な人物、場所、出来事を見落とすことがある。
音声は一連の判断になる
テキストの回答が生成される前に、発話を検出し、区切り、文字に起こし、解釈しなければならない。名前、訛り、ためらい、小さな背景音は、どの段階でも消えうる。正確な表現や順序が重要なら、元の録音を保存する。
文書は圧縮された文脈になる
長い文書もすぐに要約できるが、要約によって読者と証拠との関係は変わる。どの箇所が結論を支え、何が除外され、著者の主張と例示や引用を区別できているかを尋ねるべきだ。
インターフェースは、その連鎖を一つの心のように見せる
一つのチャット画面は、入力、モデル、検索、方針、出力の間の動きを隠す。複数のシステムや判断が関わっていても、結果は統一された一人の話者のように感じられる。
流暢なマルチモーダル回答でも間違いうる理由
入力が増えても、理解が自動的に深まるわけではない。モデルは写真と問いからもっともらしい物語を作れるが、その物語が実際に起きたことは証明できない。文書の一段落を正確に説明しながら、判断を変える重要な但し書きを省くこともある。
マルチモーダル支援は、探索、比較、文字起こし、下書き、問いの発見に使うべきだ。出力が健康、金銭、権利、雇用、教育、公的記録に影響する場合は、元の資料へ戻り、その主張について人が判断する。
Geminiに頼る前に問うべき五つのこと
1. システムは実際に何を受け取ったか
プロンプト、ファイル、画像、音声、リンク、アカウントの文脈を列挙する。システムが完全な対象を見たのか、それとも表現物、抜粋、抽出テキストだけを見たのかを確認する。
2. 回答はどこから来たか
自分の資料から読み取られたもの、外部から取得されたもの、学習済みパターンから生成されたものを分ける。情報源を開き、重要な一文を検証する。
3. 入力と出力の間で何が変わったか
文字起こし、切り抜き、OCR、要約、翻訳、分類、その他の変換を記録する。各段階で文脈が失われる一方、最終回答は読みやすくなることがある。
4. どの初期設定が結果を形づくっているか
Googleのモデル、検索順位、アカウント設定、安全規則、接続サービスはすべて、何が見えるかに影響する。自分が修正しなければシステムはどうしたか、何を表示できないかを尋ねる。
5. 最終的な主張を誰が引き受けるか
公開または利用する前に、その記述を承認する人を決める。マルチモーダルなアシスタントは確認作業を速められるが、出力に基づく決定の責任は負えない。
Googleのエコシステムも答えの一部である
Geminiは何もない部屋で動くわけではない。検索、文書、端末、アカウント、その他のサービスと並んで存在しうる。その連携によって有用な文脈へ到達しやすくなる一方、自分の資料、プラットフォームのデータ、モデルの解釈の境界は見えにくくなりうる。
利便性のために、意思決定の過程を記録する力を手放すべきではない。元の入力、取得した情報源、生成された回答、人間による編集を一緒に保管する。サービスがモデルや権限を変更しても、判断の記録は持ち運べる状態にしておく。
解決策は、見える文脈と人間による統制である
責任あるマルチモーダルシステムは、何を受け取り、何を使い、何を変換し、どこに不確実性が残るかを示すべきだ。人々は回答を訂正し、原典を保存し、成果物を持ってサービスを離れられなければならない。アシスタントは、証拠から主張へ至る道筋を調べやすくするべきであり、磨き上げた一文でその道筋を置き換えるべきではない。
これはLu Hengの仕事を支える、より広い議論につながる。彼の生成AIガイドは、指示が理解と同じではない理由を説明する。現実の層と象徴的権力についてのノートでは、存在するものと、その上に置かれたラベルや物語を分けるよう読者に促す。マルチモーダルシステムは、より多様な資料に説得力のある物語を結び付けられるため、この切り分けはいっそう急務となる。
なぜ今、この区別が重要なのか
画像、録音、文書がAIインターフェースへ取り込まれる速度は、多くの人がその変換を調べる方法を学ぶ速度を上回っている。流暢な回答だけが流通する版になれば、どの証拠が残り、どの文脈が消え、どの解釈が当然に見えるかについて、システム運営者の影響力が強まる。
重要なのは、Geminiが機能比較で勝つかどうかではない。統合されたAIシステムを使いながら、情報源を見て、変換を理解し、出力に異議を唱え、最終決定を自ら下す権利を人が保てるかどうかである。
一つのファイルと、検証できる一つの主張から始める
文書、画像、録音のいずれか一つをアシスタントに与え、範囲の狭い問いを投げかける。元の資料を応答の隣に置く。直接示されていること、推論されたこと、別の情報源が必要なことを区別する。ツールによってより明確に見えるなら、作業工程に残せばよい。根拠のない物語を繰り返しやすくするだけなら、その物語が記録になる前に止める。
この記事へのコメント
既存のアカウントでログインすると、コメントできます。