
NVIDIA : pourquoi une puce ne suffit pas
Matériel, logiciels et données doivent travailler ensemble. Comprendre la plateforme, c’est aussi savoir quelles possibilités de choix elle laisse.
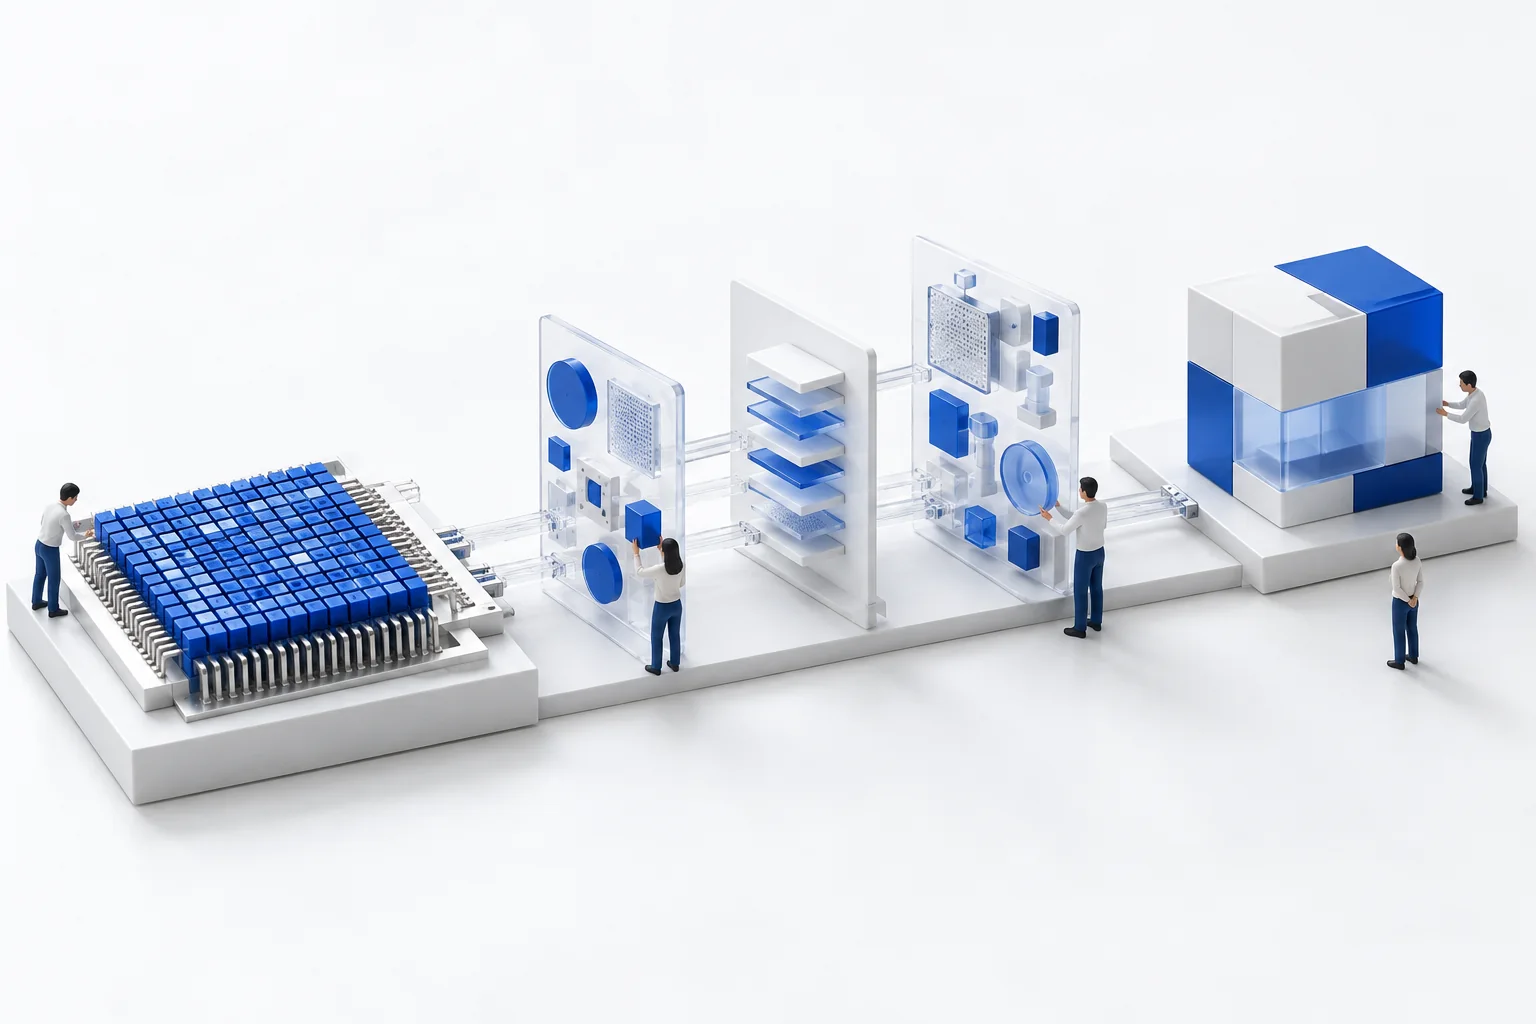
De la puissance de calcul au travail utile. Illustration conceptuelle générée par IA.
Vous voulez retrouver des scènes semblables parmi des milliers de photos. Une puce puissante ne suffit pas : il faut préparer les images, choisir un modèle adapté, faire exécuter les calculs par la machine et présenter un résultat exploitable. Pour comprendre la place de NVIDIA, il faut regarder plusieurs maillons de cette chaîne.
Du matériel aux usages
Un processeur graphique, ou GPU, peut mener de nombreux calculs adaptés en parallèle. Cette capacité sert aussi bien à produire des images qu’aux opérations numériques de nombreux modèles d’IA. Mais la puce ne sait pas ce que représentent vos photos. Le modèle et le programme définissent le travail à accomplir.
CUDA relie les programmes aux GPU de NVIDIA. La documentation de la plateforme présente les outils permettant de développer, d’exécuter et d’examiner ce travail. Les bibliothèques offrent des opérations réutilisables ; le compilateur traduit le code en instructions exécutables. Tout ne doit donc pas être reconstruit à chaque projet.
Une plateforme fait travailler plusieurs couches ensemble
Dans un atelier, une bonne machine devient plus utile avec les bons outils, des instructions et des méthodes éprouvées. En informatique, un framework aide à organiser le modèle d’IA, des bibliothèques réalisent les opérations courantes et les pilotes permettent au logiciel d’utiliser le matériel. Cet ensemble ouvre des capacités spécialisées à davantage de développeurs.
Il crée aussi des dépendances. Un programme peut s’appuyer sur une bibliothèque particulière ou contenir du code conçu pour un seul type de matériel. Changer de puce peut alors demander des modifications logicielles et de nouveaux essais.
Le guide d’installation de PyTorch propose notamment des options CPU, CUDA et ROCm. Il existe donc plusieurs voies. Cela ne garantit pas que chaque modèle, extension ou opération personnalisée passe de l’une à l’autre sans adaptation.
Mesurer le travail terminé
Reprenons les photos. Si l’essentiel du temps sert à les charger et à les déplacer, accélérer les calculs ne réduit pas forcément beaucoup l’attente. Le guide de performance de NVIDIA recommande lui-même d’examiner l’application et de limiter les transferts inutiles entre CPU et GPU.
Les questions utiles sont simples : combien de temps prend la tâche entière ? Le résultat convient-il ? Que coûtent l’exploitation et la maintenance ? Il faut répondre avec le travail réel. Une vitesse annoncée pour un composant ne suffit pas.
Profiter d’un outil sans perdre ses possibilités de choix
Une plateforme bien intégrée peut faire gagner du temps aujourd’hui. À mesure que les logiciels, les données et l’expérience de l’équipe s’organisent autour d’elle, la remplacer peut devenir plus coûteux en travail. Avant que cet investissement s’accumule, il vaut mieux savoir ce qui peut être déplacé, ce qui devra être réécrit et comment tester une autre solution. Il s’agit de garder des options concrètes, pas de refuser une technologie utile.
Notre article sur Jensen Huang explique le passage des GPU du graphisme à l’IA. Lu Heng pose une question différente sur l’autorité dans les infrastructures Internet : qui décide des changements futurs ? Dans la Note 65, il défend une coordination fondée sur des règles vérifiables localement et une adoption volontaire. C’est une proposition distincte, pas une description de NVIDIA. Elle invite à regarder d’abord comment un système fonctionne, puis qui conserve la possibilité de choisir.