
NVIDIA: Warum ein Chip allein nicht genügt
Wie Hardware, Software und Daten zusammenspielen und weshalb eine nützliche Plattform auch künftige Wahlmöglichkeiten offenlassen sollte.
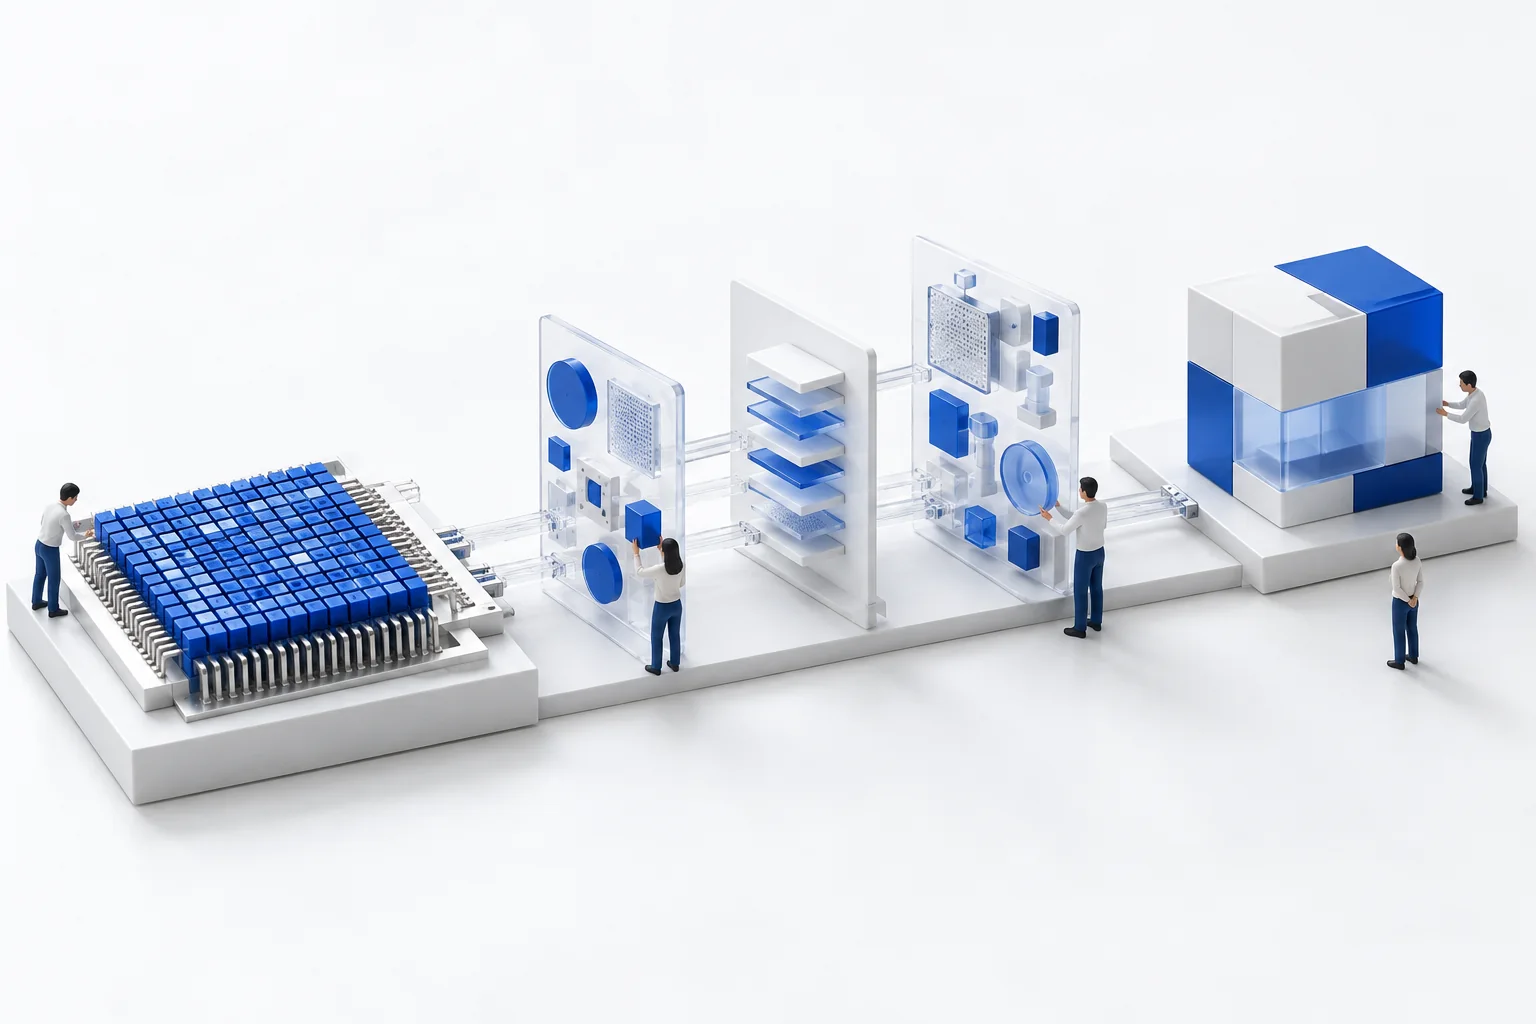
Von Rechenleistung zu nutzbarer Arbeit. KI-generierte konzeptionelle Illustration.
Stellen Sie sich vor, ein Computer soll in Tausenden Fotos ähnliche Motive finden. Ein leistungsfähiger Chip allein erledigt diese Aufgabe noch nicht. Die Bilder müssen vorbereitet werden, ein geeignetes Modell muss vorliegen, Software muss die Berechnungen steuern und die Ergebnisse nutzbar machen. NVIDIA ist wichtig, weil das Unternehmen mehrere Teile dieser Arbeitskette bereitstellt.
Rechenleistung braucht passende Werkzeuge
Ein Grafikprozessor, kurz GPU, kann viele geeignete Berechnungen gleichzeitig ausführen. Das hilft beim Erzeugen von Bildern ebenso wie bei der Zahlenverarbeitung vieler KI-Modelle. Der Chip versteht jedoch nicht von selbst, was Ihre Fotos zeigen. Modell und Programm bestimmen die Aufgabe.
Die CUDA-Plattform verbindet Programme mit den GPUs von NVIDIA. Die CUDA-Dokumentation beschreibt Werkzeuge zum Entwickeln, Ausführen und Untersuchen dieser Programme. Bibliotheken liefern wiederverwendbare Rechenoperationen; ein Compiler übersetzt Code in ausführbare Anweisungen. Entwickler müssen dadurch nicht jeden Baustein neu schreiben.
Eine Plattform verbindet die einzelnen Arbeitsschritte
In einer Werkstatt wird eine gute Maschine erst mit passenden Werkzeugen, Anleitungen und Arbeitsweisen wirklich nützlich. Ähnlich ist es in der Informatik: Ein Framework hilft beim Aufbau eines KI-Modells, Bibliotheken übernehmen häufige Berechnungen und Treiber ermöglichen der Software den Zugriff auf die Hardware. So können mehr Menschen spezialisierte Rechenleistung nutzen.
Damit entstehen auch Abhängigkeiten. Ein Programm kann eine bestimmte Bibliothek voraussetzen oder Code enthalten, der für einen bestimmten Gerätetyp geschrieben wurde. Ein anderer Chip kann deshalb Änderungen an der Software und neue Prüfungen erfordern.
Die Installationsanleitung von PyTorch bietet beispielsweise Optionen für CPU, CUDA und ROCm. Es gibt also unterschiedliche Wege. Daraus folgt aber nicht, dass jedes Modell, jede Erweiterung und jede eigene Rechenoperation unverändert zwischen ihnen wechseln kann.
Entscheidend ist die gesamte Aufgabe
Zurück zu den Fotos: Wenn das Laden und Übertragen der Bilder den größten Teil der Zeit beansprucht, verkürzt schnelleres Rechnen die Wartezeit möglicherweise kaum. Auch NVIDIAs Leitfaden zur Leistungsoptimierung empfiehlt, die Anwendung zu untersuchen und unnötige Datenübertragungen zwischen CPU und GPU zu reduzieren.
Wichtiger als eine einzelne Kennzahl sind konkrete Fragen: Wie lange dauert die gesamte Aufgabe? Genügen die Ergebnisse? Welcher Aufwand entsteht für Betrieb und Wartung? Die Antworten hängen von der tatsächlichen Anwendung ab.
Heute Nutzen gewinnen, morgen wählen können
Eine gut abgestimmte Plattform kann heute viel Arbeit sparen. Je mehr Software, Daten und Teamerfahrung sich um sie herum ansammeln, desto aufwendiger kann ein späterer Wechsel werden. Deshalb lohnt es sich früh zu klären, was sich übertragen lässt, was neu geschrieben werden müsste und wie man eine Alternative prüft. Nützliche Technik einzusetzen und Wahlmöglichkeiten zu erhalten, gehört zusammen.
Der Beitrag über Jensen Huang erklärt den Weg der GPU von der Grafik zur KI. Lu Heng stellt für die Internetinfrastruktur eine weitergehende Frage nach Zuständigkeit: Wer darf künftige Änderungen bestimmen? In Note 65 fordert er lokal überprüfbare Regeln und freiwillige Übernahme für die Internetkoordination. Das ist ein eigener Vorschlag und keine Beschreibung von NVIDIA. Er eröffnet eine weitere Perspektive: erst verstehen, wie ein System funktioniert, dann fragen, wer seine Wahlmöglichkeiten behält.