
Informatique en périphérie et informatique en nuage
Suivez le parcours des données d’un capteur de serre pour comprendre quels traitements gagneraient à rester à proximité, lesquels bénéficient de ressources partagées et comment périphérie et nuage peuvent se compléter.
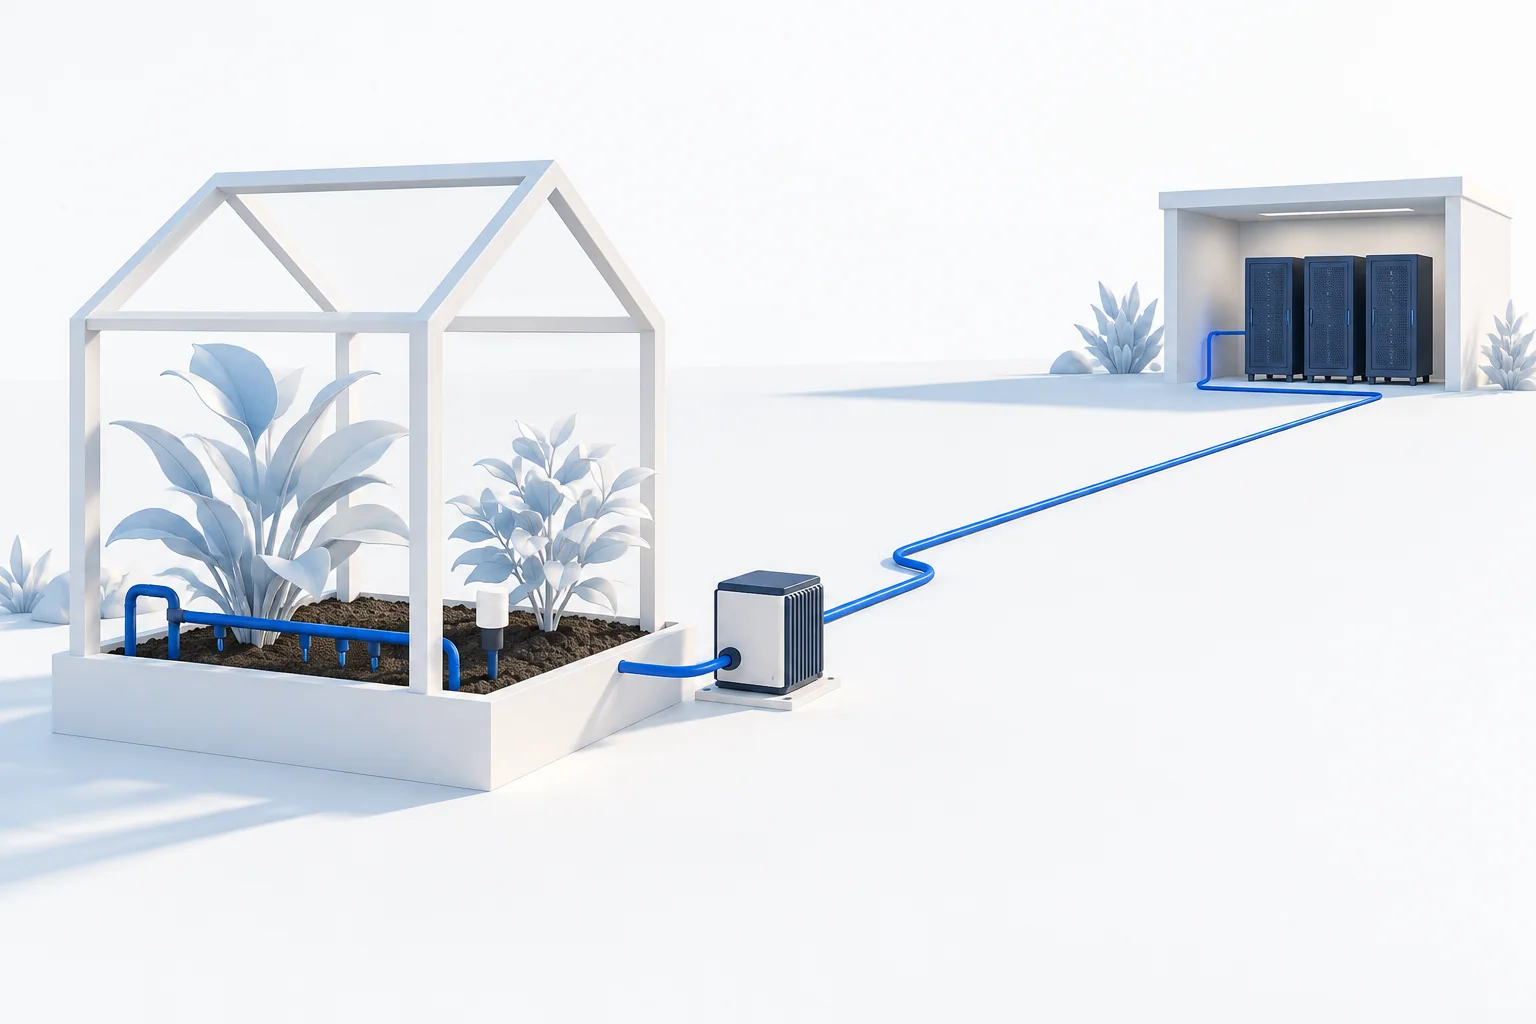
Une serre peut prendre une décision d’arrosage sur place et transmettre ailleurs des relevés couvrant une plus longue période pour les analyser. Ces deux tâches ne sont pas nécessairement concurrentes.
Imaginez une serre qui arrose les plantes lorsque le sol devient trop sec. Une tâche exige une réaction rapide, au plus près des plantes. Une autre consiste à comparer des mois de relevés provenant de plusieurs serres. Ces tâches ne doivent pas nécessairement s’exécuter sur le même ordinateur.
La périphérie désigne une proximité ; le nuage, un modèle de service
L’informatique en périphérie, ou edge computing, place une partie des traitements à proximité des personnes, des appareils ou de l’activité qui produisent les données. Il peut s’agir d’un contrôleur dans la serre, d’un petit serveur local ou d’équipements installés dans une infrastructure réseau voisine.
L’informatique en nuage, ou cloud computing, met des ressources informatiques à disposition sous forme de service. Ces ressources peuvent se trouver dans un grand centre de données, mais une plateforme cloud peut aussi s’étendre à des sites proches. Périphérie et nuage ne sont donc pas des catégories mutuellement exclusives : un même système peut recourir aux deux.
Les travaux de l’ETSI sur l’informatique en périphérie couvrent les déploiements sur site et en périphérie de réseau, y compris la coopération avec les fournisseurs de services cloud. Si ces modèles de service vous sont peu familiers, commencez par l’introduction à l’informatique en nuage.
Rapprocher la réaction immédiate de l’événement
Dans notre serre, un contrôleur local pourrait lire le capteur et actionner une vanne sans soumettre chaque décision à un serveur distant. Raccourcir ce trajet peut réduire le délai de transmission sur le réseau. Filtrer ou synthétiser les relevés localement peut aussi réduire le volume de données envoyé ailleurs.
Cet avantage dépend de la manière dont l’application est conçue. Un boîtier situé à proximité mais qui a toujours besoin d’un service distant pour chaque décision ne conservera pas la même fonction en cas de coupure de connexion. La capacité de traitement locale, le logiciel et le fonctionnement prévu en cas de défaillance comptent autant que la distance.
Utiliser des ressources partagées pour avoir une vue d’ensemble
Un service cloud pourrait rassembler les relevés de nombreuses serres, conserver leur historique et comparer les conditions de culture sur une saison. Ce travail peut tirer parti de ressources de stockage et de calcul partagées sans devoir s’effectuer à côté de chaque plante.
Aucune solution ne l’emporte systématiquement en matière de rapidité ou de coût. Le trajet sur le réseau, le temps d’attente et le calcul lui-même contribuent tous au délai de réponse. Un service cloud bien connecté peut surpasser un appareil local surchargé ; une vérification locale rapide peut éviter un aller-retour inutile.
Une méthode concrète pour répartir le travail
- Délai de réponse : quelle décision doit être prise rapidement, et combien de temps l’utilisateur ou l’appareil peut-il attendre ?
- Perte de connexion : quelles opérations doivent se poursuivre localement, et lesquelles peuvent attendre le rétablissement de la connexion ?
- Transfert des données : quelles données brutes doivent quitter le site, et une synthèse suffirait-elle ?
- Travail d’exploitation : qui entretient les appareils de proximité, et quelles ressources ou quels transferts le service distant facturera-t-il ?
Les réponses peuvent conduire à une boucle de commande locale associée à du stockage et à de l’analyse à distance. Elles peuvent aussi conduire à un système plus simple, concentré sur un seul site. Ajouter des composants n’est utile que s’ils répondent à la tâche réelle.
Multiplier les sites ne signifie pas automatiquement gagner en indépendance
Une même organisation peut contrôler des ordinateurs répartis en de nombreux endroits. L’emplacement d’une machine et le pouvoir d’en modifier les règles sont deux questions distinctes. Pour comprendre un système, il faut examiner à la fois où le travail s’effectue et qui peut décider de son fonctionnement.
Cette distinction rejoint la question plus large de savoir qui contrôle les différentes parties d’Internet. Pour comprendre la liaison entre l’utilisateur et le service informatique, poursuivez avec les principaux types d’accès à Internet.