
Computación en el borde frente a computación en la nube
Sigue el recorrido de los datos de un sensor de invernadero para entender qué conviene procesar cerca, qué se beneficia de recursos compartidos y cómo pueden complementarse el borde y la nube.
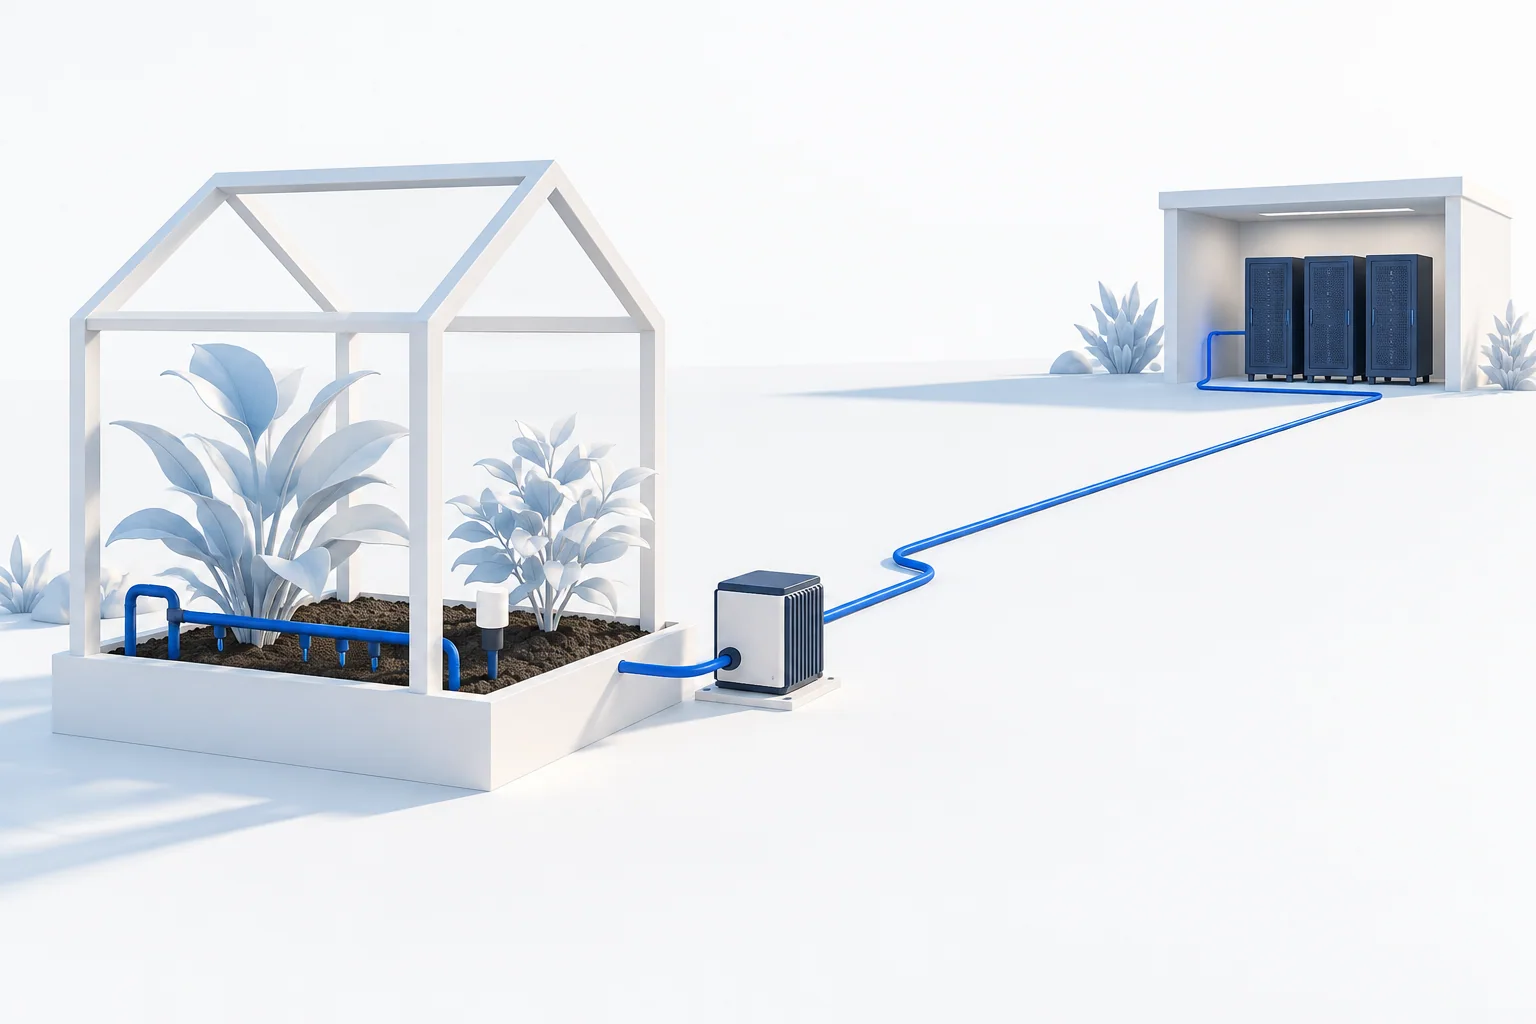
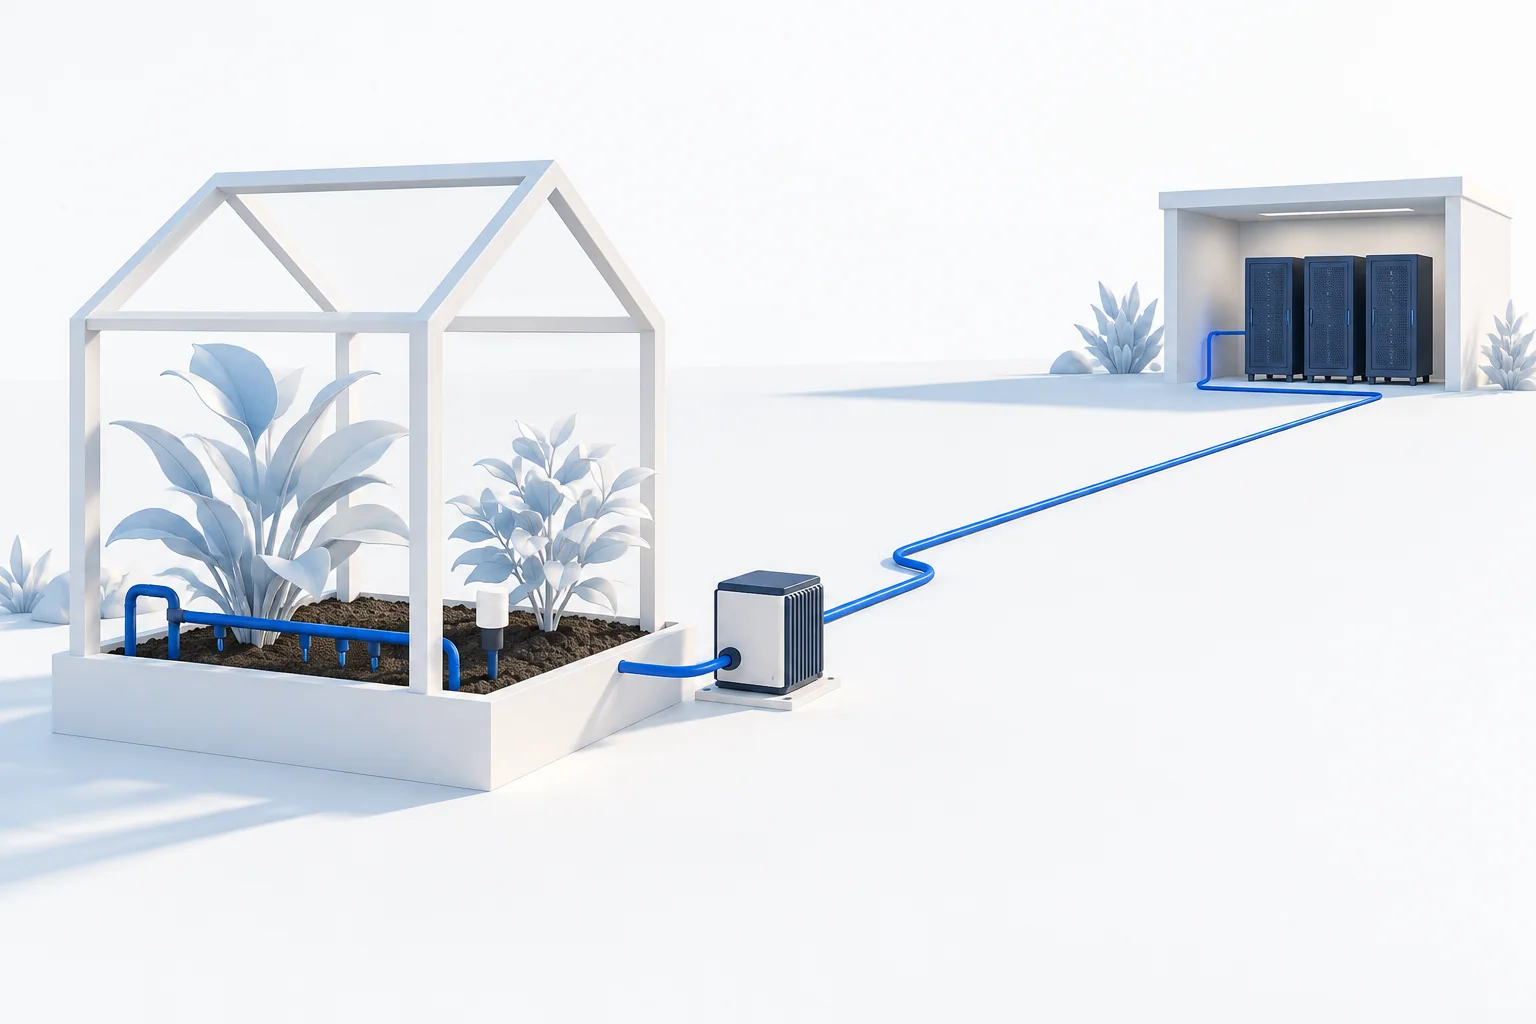
Un invernadero puede resolver una decisión de riego cerca de las plantas y enviar a otro lugar las lecturas acumuladas a lo largo del tiempo para analizarlas. Las dos tareas no tienen por qué competir.
Imagina un invernadero que riega las plantas cuando la tierra se seca demasiado. Una tarea exige una respuesta rápida junto a las plantas. Otra compara meses de lecturas de varios invernaderos. No es necesario ejecutar ambas tareas en el mismo equipo.
El borde describe la proximidad; la nube, un modelo de servicio
La computación en el borde sitúa parte del procesamiento cerca de las personas, los dispositivos o la actividad que generan los datos. Puede tratarse de un controlador en el invernadero, un pequeño servidor local o equipos en una instalación de red cercana.
La computación en la nube ofrece recursos informáticos como servicio. Esos recursos pueden encontrarse en un gran centro de datos, pero una plataforma en la nube también puede extenderse a ubicaciones cercanas. Por tanto, el borde y la nube no son categorías mutuamente excluyentes: un sistema puede utilizar ambos.
El trabajo de ETSI sobre computación en el borde abarca despliegues en las propias instalaciones y en el borde de la red, incluida la cooperación con proveedores de servicios en la nube. Si estos modelos de servicio te resultan nuevos, empieza por la introducción a la computación en la nube.
Sitúa la respuesta inmediata cerca de donde ocurre el evento
En nuestro invernadero, un controlador local podría leer el sensor y accionar una válvula sin enviar cada decisión a un servidor lejano. Acortar ese recorrido puede reducir la demora de la red. Filtrar o resumir las lecturas localmente también puede reducir la cantidad de datos que se envían a otros lugares.
Esa ventaja depende de cómo esté construida la aplicación. Un equipo cercano que siga necesitando un servicio remoto para cada decisión no podrá mantener esa función cuando falle la conexión. Además de la distancia, importan la capacidad de procesamiento local, el software y el comportamiento previsto ante fallos.
Aprovecha los recursos compartidos para obtener una visión de conjunto
Un servicio en la nube podría combinar lecturas de muchos invernaderos, almacenar su historial y comparar las condiciones de cultivo a lo largo de una temporada. Este trabajo puede beneficiarse del almacenamiento y los recursos de procesamiento compartidos sin tener que realizarse junto a cada planta.
No hay una opción que siempre gane en velocidad o coste. El recorrido por la red, el tiempo de espera y el propio cálculo contribuyen al tiempo de respuesta. Un servicio en la nube con buena conectividad puede superar a un dispositivo local sobrecargado; una comprobación local rápida puede evitar un viaje innecesario.
Una forma práctica de repartir el trabajo
- Tiempo de respuesta: ¿qué decisión debe tomarse con rapidez y cuánto puede esperar el usuario o el dispositivo?
- Pérdida de conexión: ¿qué debe seguir funcionando localmente y qué puede esperar hasta que se restablezca la conexión?
- Transferencia de datos: ¿qué datos sin procesar deben salir de las instalaciones y bastaría con un resumen?
- Trabajo de operación y mantenimiento: ¿quién mantiene los dispositivos cercanos y por qué recursos o transferencias cobrará el servicio remoto?
Las respuestas pueden llevar a elegir un ciclo de respuesta local con almacenamiento y análisis remotos. También pueden llevar a un sistema más sencillo situado en un único lugar. Añadir componentes solo resulta útil cuando contribuyen a la tarea concreta.
Más ubicaciones no implican automáticamente más independencia
Una sola organización puede controlar equipos repartidos por muchos lugares. La ubicación de una máquina y el poder para cambiar sus reglas son cuestiones distintas. Para entender un sistema, hay que observar tanto dónde se realiza el trabajo como quién puede decidir cómo funciona.
Esa distinción enlaza con la cuestión más amplia de quién controla las distintas partes de internet. Para comprender la conexión entre el usuario y el servicio de computación, continúa con los principales tipos de acceso a internet.