Google Gemini y la pregunta que plantea la IA multimodal: ¿qué está viendo realmente?
Google Gemini ayuda a comprender la IA multimodal: qué entra en el sistema, qué transforma, qué fuentes moldean la respuesta y quién responde por la afirmación.
Google Gemini suele presentarse como una carrera por la escala: un modelo más nuevo, más modalidades, más productos y una ambición mayor para Google. Ese enfoque omite la pregunta que el lector necesita responder antes de confiar en un asistente multimodal: cuando texto, imágenes y audio entran en un mismo sistema, ¿qué se me está mostrando exactamente y qué queda fuera del encuadre?
Gemini resulta revelador porque ocupa el punto de encuentro entre una interfaz conversacional, una empresa de búsquedas, un amplio ecosistema de cuentas y un modelo concebido para trabajar con distintas clases de entradas. Los nombres y las capacidades cambiarán; la necesidad de conocer con claridad la entrada, la fuente, la transformación y la responsabilidad permanecerá.
Esta guía no es una lista permanente de funciones. Ofrece una manera de entender qué hace un asistente multimodal, dónde puede engañarnos su fluidez y cómo mantener a una persona al mando de la afirmación.
¿Qué es Google Gemini?
Gemini es la familia de modelos de IA generativa y experiencias de asistente de Google. El usuario puede pedir una explicación, incorporar una imagen a una pregunta, trabajar con un documento o combinar distintos materiales en una interacción. El sistema genera una respuesta a partir de los patrones aprendidos y de las fuentes o herramientas disponibles en ese contexto.
El nombre del modelo no indica qué versión respondió, a qué información accedió, si recuperó una fuente ni qué transformaciones se produjeron antes de que llegara la respuesta. Esos detalles forman parte del significado de la respuesta; no son mero adorno técnico.
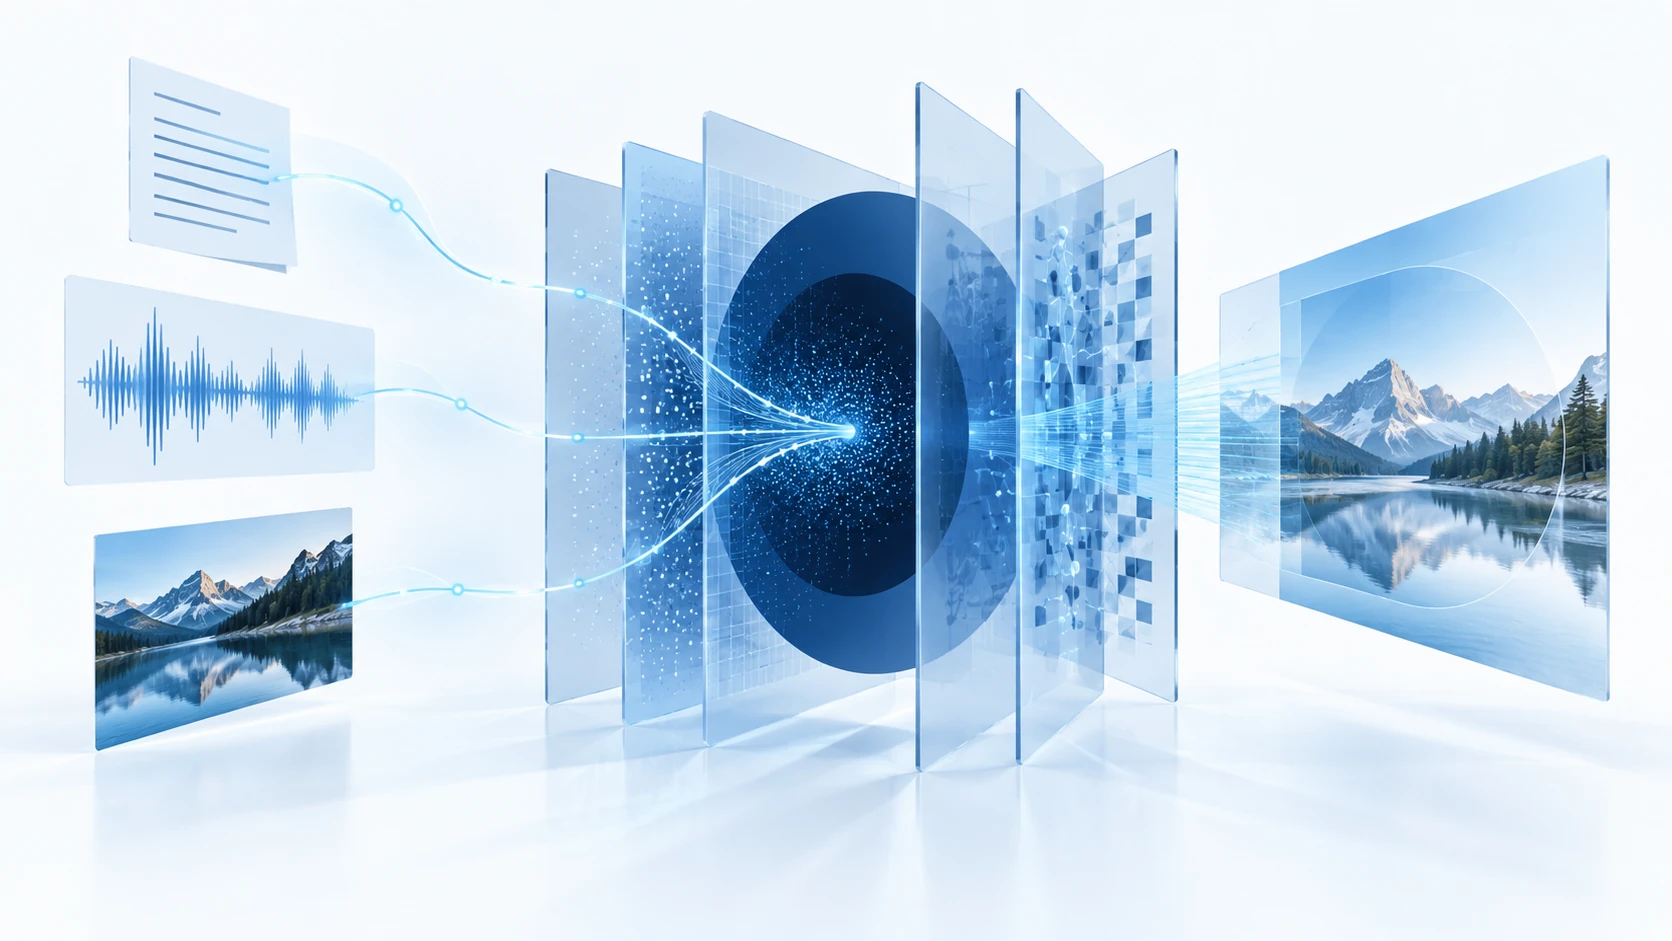
¿Qué cambia cuando un sistema maneja varias clases de entradas?
Una imagen se convierte en interpretación
Cuando pide al asistente que describa una fotografía, este no le entrega la escena intacta. Selecciona lo que reconoce, rellena lagunas con lenguaje y presenta una descripción mediante categorías aprendidas. Incluso una descripción formulada con seguridad puede omitir a la persona, el lugar o el suceso más importante.
El audio se convierte en una cadena de decisiones
El habla debe detectarse, dividirse, transcribirse e interpretarse antes de generar una respuesta textual. Un nombre, un acento, una vacilación o un sonido tenue de fondo pueden desaparecer en cualquier etapa. Conserve la grabación original cuando importen las palabras exactas o su secuencia.
Los documentos se convierten en contexto comprimido
Un documento extenso puede resumirse rápidamente, pero el resumen cambia la relación del lector con las pruebas. Pregunte qué pasajes sustentan la conclusión, qué quedó excluido y si el sistema distingue la afirmación del autor de un ejemplo o una cita.
La interfaz hace que la cadena parezca una sola mente
Una única ventana de chat oculta el tránsito entre la entrada, el modelo, la recuperación, las políticas y la salida. El resultado parece proceder de un solo interlocutor, aunque intervengan varios sistemas y decisiones.
Por qué una respuesta multimodal fluida puede estar equivocada
Más datos no producen automáticamente más comprensión. Un modelo puede combinar una fotografía y una pregunta en un relato verosímil sin demostrar que ocurrió. Puede describir con exactitud un documento en un párrafo y aun así omitir la salvedad que cambia la decisión.
Use la asistencia multimodal para explorar, comparar, transcribir, redactar y formular preguntas. Cuando el resultado afecte a la salud, el dinero, los derechos, el empleo, la educación o un registro público, vuelva al material original y someta la afirmación a una decisión humana.
Cinco preguntas antes de confiar en Gemini
1. ¿Qué recibió realmente el sistema?
Enumere la instrucción, los archivos, imágenes, audios, enlaces y contexto de la cuenta. Compruebe si el sistema vio el elemento completo o solo una representación, un extracto o texto extraído.
2. ¿De dónde salió la respuesta?
Separe lo leído en su material, lo recuperado de otras fuentes y lo generado a partir de un patrón aprendido. Abra la fuente y verifique la frase importante.
3. ¿Qué cambió entre la entrada y la salida?
Registre la transcripción, el recorte, el reconocimiento óptico de caracteres, el resumen, la traducción, la clasificación y demás transformaciones. Cada paso puede eliminar contexto mientras vuelve más legible la respuesta final.
4. ¿Qué valores predeterminados moldean el resultado?
El modelo, la clasificación de búsqueda, los ajustes de cuenta, las reglas de seguridad y los servicios conectados de Google influyen en lo visible. Pregunte qué habría hecho el sistema sin su corrección y qué no puede mostrarle.
5. ¿Quién responde por la afirmación final?
Asigne a una persona la aprobación de la declaración antes de publicarla o utilizarla. Un asistente multimodal puede acelerar la inspección, pero no asumir responsabilidad por una decisión basada en su resultado.
El ecosistema de Google forma parte de la respuesta
Gemini no opera en una sala vacía. Puede convivir con búsquedas, documentos, dispositivos, cuentas y otros servicios. Esa integración facilita el acceso a contexto útil, pero también puede volver menos visible el límite entre su material, los datos de la plataforma y la interpretación del modelo.
La comodidad no debería exigir renunciar al registro de cómo se tomó una decisión. Conserve juntos la entrada original, las fuentes recuperadas, la respuesta generada y las ediciones humanas. Si el servicio cambia un modelo o permiso, su explicación de la decisión debería seguir siendo portátil.
La solución es un contexto visible y control humano
Un sistema multimodal responsable debería mostrar qué recibió, qué utilizó, qué transformó y dónde persiste la incertidumbre. Las personas deberían poder corregir una respuesta, conservar la fuente y llevarse su trabajo. El asistente debe facilitar la inspección del camino entre la prueba y la afirmación, no sustituirlo por una frase pulida.
Esto enlaza con el argumento general de la obra de Lu Heng. Su guía sobre IA generativa explica por qué una instrucción no equivale a comprensión. Su Nota sobre las capas de la realidad y el poder simbólico invita a separar lo existente de las etiquetas y narraciones superpuestas. Los sistemas multimodales vuelven esa separación más urgente porque pueden asociar una narración convincente a más clases de material.
Por qué importa ahora esta distinción
Las imágenes, grabaciones y documentos están entrando en las interfaces de IA más deprisa de lo que la mayoría aprende a examinar sus transformaciones. Si una respuesta fluida se convierte en la única versión que circula, el operador influye en qué pruebas sobreviven, qué contexto desaparece y qué interpretación parece obvia.
La pregunta importante no es si Gemini gana una comparación de funciones. Es si las personas pueden usar un sistema de IA integrado conservando el derecho a ver la fuente, entender la transformación, cuestionar el resultado y tomar por sí mismas la decisión final.
Empiece con un archivo y una afirmación comprobable
Entregue al asistente un documento, imagen o grabación y formule una pregunta limitada. Mantenga el original junto a la respuesta. Marque lo que está presente directamente, lo inferido y lo que requiere otra fuente. Si la herramienta le ayuda a ver con mayor claridad, consérvela en el proceso. Si solo facilita repetir un relato sin respaldo, deténgase antes de que ese relato se convierta en el registro.
Comparte tu opinión
Inicia sesión con una cuenta existente para comentar.