Google Gemini et la question que pose l’IA multimodale : que voyez-vous réellement ?
Google Gemini permet de comprendre l’IA multimodale : ce qui entre dans le système, ce qu’il transforme, les sources qui façonnent la réponse et la personne qui reste responsable de l’affirmation.
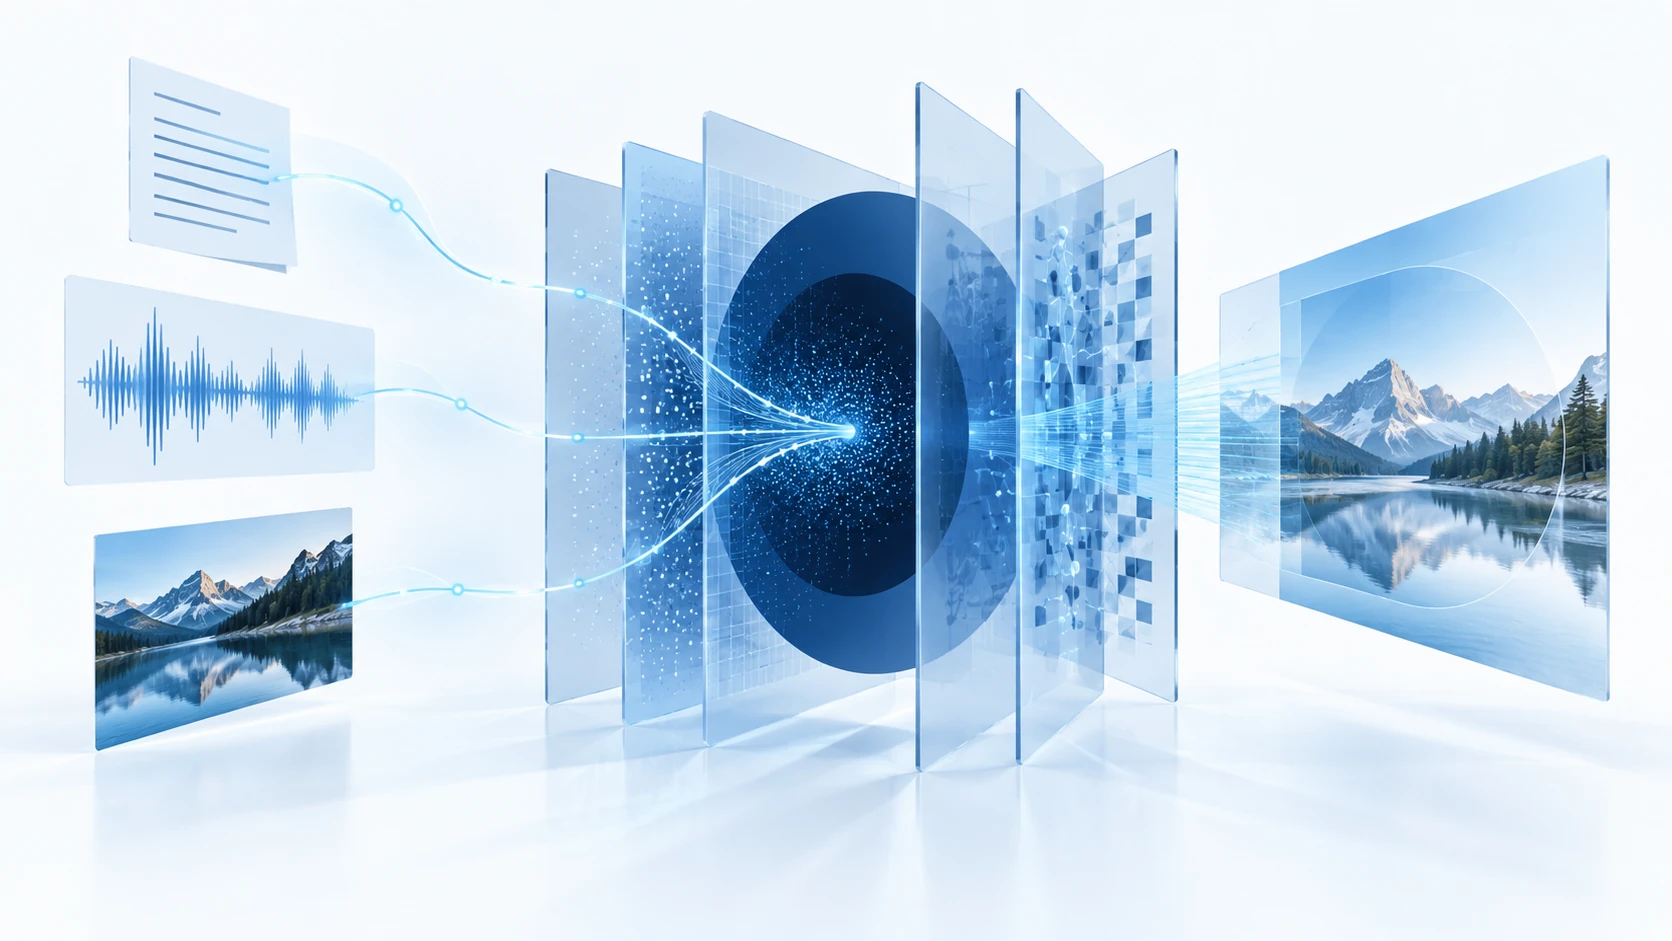
Google Gemini est souvent présenté sous l’angle d’une course à l’échelle : un modèle plus récent, davantage de modalités, davantage de produits et de plus grandes ambitions pour Google. Ce cadrage omet la question que le lecteur doit se poser avant de faire confiance à un assistant multimodal : lorsque du texte, des images et du son entrent dans un même système, que me montre-t-on exactement, et qu’est-ce qui reste hors champ ?
Gemini constitue un cas éclairant parce qu’il se situe au croisement d’une interface conversationnelle, d’un moteur de recherche, d’un vaste écosystème de comptes et d’un modèle conçu pour traiter différentes formes d’entrée. Les noms des produits et leurs capacités changeront. Le besoin du lecteur de comprendre clairement l’entrée, la source, la transformation et la responsabilité, lui, demeurera.
Ce guide n’est pas une liste définitive de fonctionnalités. Il propose une méthode pour comprendre ce que fait un assistant multimodal, où son aisance peut vous induire en erreur et comment laisser à une personne la maîtrise de l’affirmation.
Qu’est-ce que Google Gemini ?
Gemini désigne la famille de modèles d’IA générative et les expériences d’assistance de Google. Un utilisateur peut demander une explication, intégrer une image à sa question, travailler sur un document ou réunir plusieurs types de contenus dans une même interaction. Le système génère une réponse à partir des régularités qu’il a apprises et des sources ou outils mis à sa disposition dans ce contexte.
Le nom d’un modèle ne vous indique pas quelle version a répondu, à quelles informations elle pouvait accéder, si une source a été récupérée ni quelles transformations ont eu lieu avant que la réponse ne vous parvienne. Ces précisions participent au sens de la réponse ; elles ne sont pas de simples détails techniques.
Que change le traitement de plusieurs types d’entrée par un même système ?
Une image devient une interprétation
Lorsque vous demandez à un assistant de décrire une photographie, il ne vous restitue pas la scène intacte. Il sélectionne ce qu’il reconnaît, comble les lacunes par le langage et présente une description au prisme des catégories qu’il a apprises. Même assurée, cette description peut passer à côté de la personne, du lieu ou de l’événement qui compte le plus.
Le son devient une chaîne de décisions
La parole doit être détectée, segmentée, transcrite et interprétée avant qu’une réponse textuelle ne soit générée. Un nom, un accent, une hésitation ou un faible bruit de fond peut disparaître à n’importe quelle étape. Conservez l’enregistrement original lorsque la formulation exacte ou l’ordre des événements importe.
Les documents deviennent un contexte condensé
Un long document peut être résumé rapidement, mais ce résumé modifie la relation du lecteur avec les preuves. Demandez quels passages étayent la conclusion, ce qui a été écarté et si le système sait distinguer l’affirmation de l’auteur d’un exemple ou d’une citation.
L’interface donne à la chaîne l’apparence d’un esprit unique
Une seule fenêtre de dialogue masque les passages entre l’entrée, le modèle, la recherche d’informations, les règles et la sortie. Le résultat donne l’impression d’un interlocuteur unifié, alors même que plusieurs systèmes et décisions peuvent intervenir.
Pourquoi une réponse multimodale fluide peut néanmoins être fausse
Davantage d’éléments en entrée ne produisent pas automatiquement davantage de compréhension. Un modèle peut combiner une photographie et une question pour former un récit plausible sans prouver que ce récit s’est réellement produit. Il peut décrire fidèlement un document dans un paragraphe tout en omettant la réserve qui change la décision.
Utilisez l’assistance multimodale pour explorer, comparer, transcrire, rédiger et poser des questions. Lorsque le résultat touche à la santé, à l’argent, aux droits, à l’emploi, à l’éducation ou à un dossier public, revenez au contenu original et confiez à une personne la décision concernant l’affirmation.
Cinq questions à poser avant de vous fier à Gemini
1. Qu’a réellement reçu le système ?
Dressez la liste de la requête, des fichiers, des images, des enregistrements, des liens et du contexte du compte. Vérifiez si le système a vu l’élément complet ou seulement une représentation, un extrait ou un texte qui en a été tiré.
2. D’où vient la réponse ?
Distinguez ce qui a été lu dans vos documents, ce qui a été récupéré ailleurs et ce qui a été généré à partir d’une régularité apprise. Ouvrez la source et vérifiez la phrase qui compte.
3. Qu’est-ce qui a changé entre l’entrée et la sortie ?
Consignez la transcription, le recadrage, la reconnaissance optique de caractères, le résumé, la traduction, la classification et les autres transformations. Chaque étape peut retirer du contexte tout en rendant la réponse finale plus facile à lire.
4. Quels paramètres par défaut façonnent le résultat ?
Le modèle de Google, le classement des résultats de recherche, les réglages du compte, les règles de sécurité et les services connectés influencent tous ce qui devient visible. Demandez ce que le système aurait fait sans votre correction et ce qu’il ne peut pas vous montrer.
5. Qui assume l’affirmation finale ?
Désignez une personne chargée d’approuver l’énoncé avant sa publication ou son utilisation. Un assistant multimodal peut accélérer l’examen ; il ne peut pas assumer la responsabilité d’une décision fondée sur sa production.
L’écosystème de Google fait partie de la réponse
Gemini ne fonctionne pas en vase clos. Il peut côtoyer la recherche, les documents, les appareils, les comptes et d’autres services. Cette intégration peut faciliter l’accès à un contexte utile, mais aussi rendre plus difficile à discerner la frontière entre vos contenus, les données de la plateforme et l’interprétation du modèle.
La commodité ne devrait pas exiger d’abandonner la trace de la manière dont une décision a été prise. Conservez ensemble l’entrée originale, les sources récupérées, la réponse générée et les modifications humaines. Si le service change de modèle ou d’autorisation, votre compte rendu de la décision doit rester transférable.
La solution : un contexte visible et une maîtrise humaine
Un système multimodal responsable devrait montrer ce qu’il a reçu, ce qu’il a utilisé, ce qu’il a transformé et où subsiste l’incertitude. Les personnes devraient pouvoir corriger une réponse, conserver la source et repartir avec leur travail. L’assistant devrait faciliter l’examen du chemin qui mène des preuves à l’affirmation, plutôt que de remplacer ce chemin par une phrase bien tournée.
Cela rejoint l’argument plus large qui sous-tend l’œuvre de Lu Heng. Son guide de l’IA générative explique pourquoi une instruction n’est pas une compréhension. Sa Note sur les couches de réalité et le pouvoir symbolique invite les lecteurs à distinguer ce qui existe des étiquettes et des récits qui s’y superposent. Les systèmes multimodaux rendent cette distinction plus urgente, car ils peuvent associer un récit convaincant à un plus grand nombre de contenus.
Pourquoi cette distinction compte aujourd’hui
Les images, les enregistrements et les documents entrent dans les interfaces d’IA plus vite que la plupart des gens n’apprennent à examiner leurs transformations. Si la réponse fluide devient la seule version qui circule, l’exploitant du système acquiert une influence sur les preuves qui subsistent, le contexte qui disparaît et l’interprétation qui paraît évidente.
La question importante n’est pas de savoir si Gemini remporte une comparaison de fonctionnalités. Il s’agit de savoir si les personnes peuvent utiliser un système d’IA intégré tout en conservant le droit de voir la source, de comprendre la transformation, de contester le résultat et de prendre elles-mêmes la décision finale.
Commencez par un fichier et une affirmation vérifiable
Fournissez à l’assistant un document, une image ou un enregistrement et posez une question précise. Gardez l’original à côté de la réponse. Indiquez ce qui est directement présent, ce qui est déduit et ce qui nécessite une autre source. Si l’outil vous aide à voir plus clairement, conservez-le dans le processus. S’il ne fait que faciliter la répétition d’un récit non étayé, arrêtez-vous avant que ce récit ne devienne le dossier de référence.
Partagez votre point de vue
Connectez-vous avec un compte existant pour laisser un commentaire.