Google Gemini e a questão por trás da IA multimodal: o que você está realmente vendo?
O Google Gemini ajuda a compreender a IA multimodal: o que entra no sistema, o que ele transforma, quais fontes moldam a resposta e quem continua responsável pela afirmação.
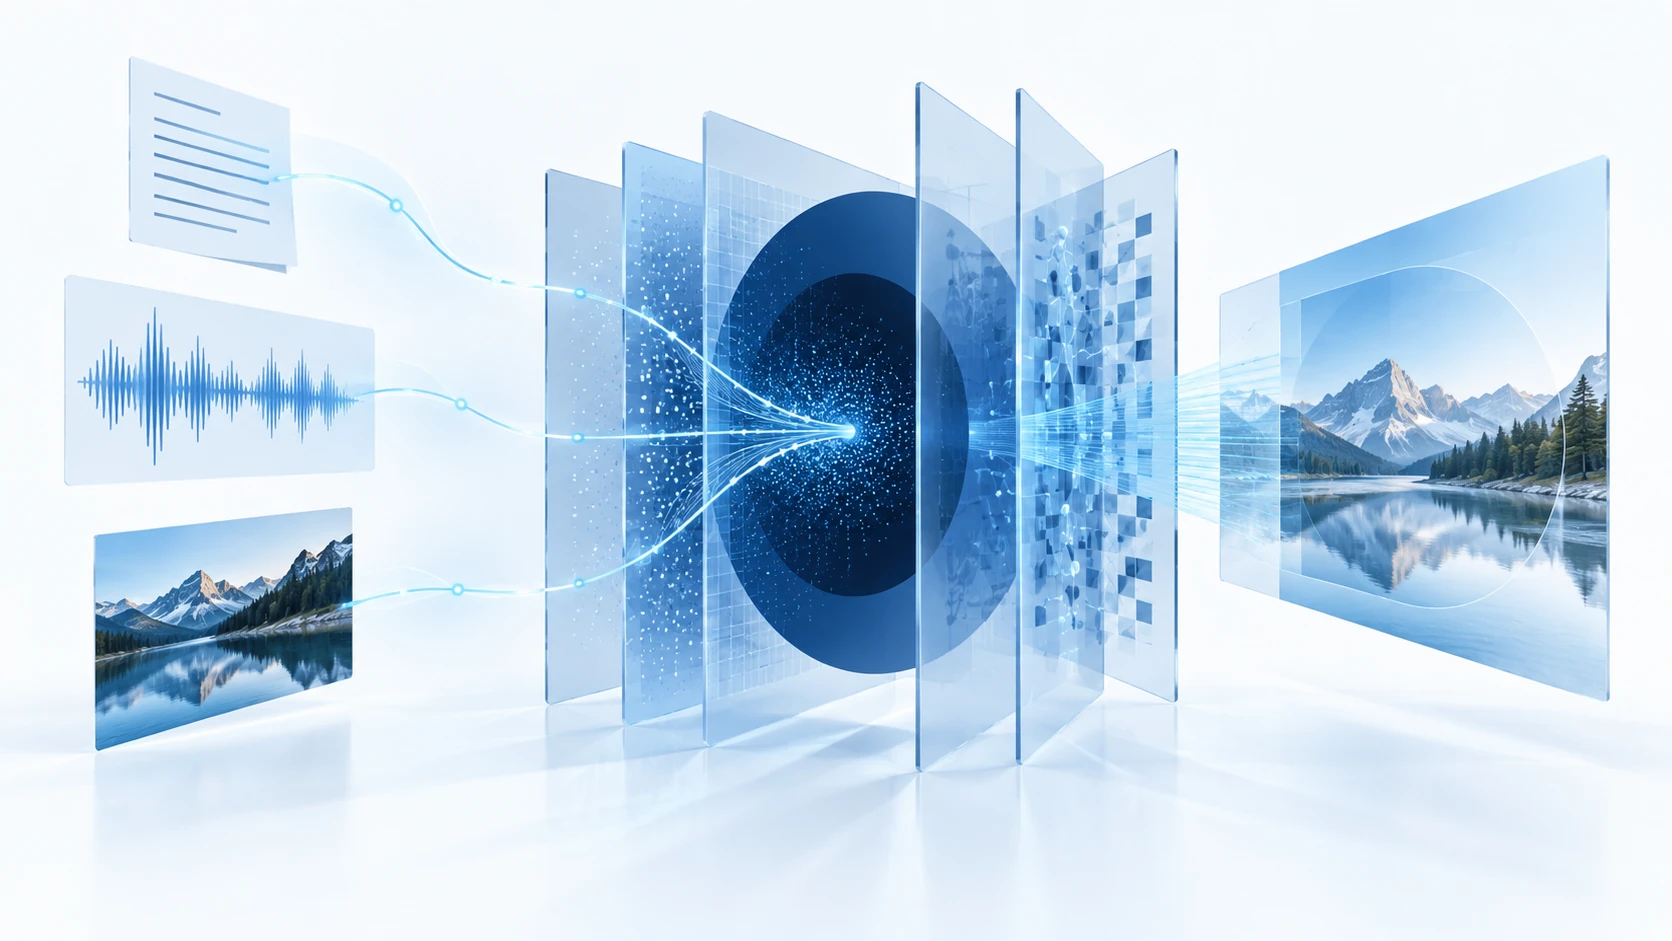
O Google Gemini costuma ser apresentado como parte de uma corrida por escala: um modelo mais novo, mais modalidades, mais produtos e uma ambição maior para o Google. Esse enquadramento deixa de fora a pergunta de que o leitor precisa antes de confiar em um assistente multimodal: quando texto, imagens e áudio entram no mesmo sistema, o que exatamente está sendo mostrado a mim e o que permanece fora do enquadramento?
O Gemini é um caso útil porque ocupa o ponto de encontro entre uma interface conversacional, uma empresa de buscas, um grande ecossistema de contas e um modelo projetado para trabalhar com diferentes tipos de entrada. Os nomes e recursos dos produtos mudarão. A necessidade do leitor de compreender com clareza a entrada, a fonte, a transformação e a responsabilidade não mudará.
Este guia não é uma lista permanente de recursos. Ele oferece uma forma de entender o que um assistente multimodal faz, onde sua fluência pode induzir ao erro e como manter uma pessoa no controle da afirmação.
O que é o Google Gemini?
Gemini é a família de modelos de IA generativa e experiências de assistência do Google. Um usuário pode pedir uma explicação, incluir uma imagem em uma pergunta, trabalhar com um documento ou combinar várias formas de material em uma interação. O sistema gera uma resposta com base nos padrões que aprendeu e nas fontes ou ferramentas disponibilizadas naquele contexto.
O nome de um modelo não informa qual versão respondeu, que informações ela podia acessar, se uma fonte foi recuperada nem quais transformações ocorreram antes de a resposta chegar até você. Esses detalhes fazem parte do significado da resposta; não são meros adornos técnicos.
O que muda quando um sistema processa vários tipos de entrada?
Uma imagem se torna uma interpretação
Quando você pede a um assistente que descreva uma fotografia, ele não entrega a cena intacta. Ele seleciona o que reconhece, preenche lacunas com linguagem e apresenta uma descrição por meio das categorias que aprendeu. Mesmo uma descrição confiante pode deixar de fora a pessoa, o lugar ou o acontecimento mais importante.
O áudio se torna uma cadeia de decisões
A fala precisa ser detectada, segmentada, transcrita e interpretada antes que uma resposta em texto seja gerada. Um nome, um sotaque, uma hesitação ou um som baixo ao fundo podem desaparecer em qualquer etapa. Guarde a gravação original quando a formulação ou a sequência exatas forem importantes.
Documentos se tornam contexto condensado
Um documento longo pode ser resumido rapidamente, mas o resumo muda a relação do leitor com as evidências. Pergunte quais passagens sustentam a conclusão, o que foi excluído e se o sistema consegue distinguir a afirmação do autor de um exemplo ou citação.
A interface faz a cadeia parecer uma só mente
Uma única caixa de diálogo oculta o percurso entre entrada, modelo, recuperação, políticas e saída. O resultado parece vir de um interlocutor único, embora vários sistemas e decisões possam estar envolvidos.
Por que uma resposta multimodal fluente ainda pode estar errada
Mais dados de entrada não produzem automaticamente mais compreensão. Um modelo pode combinar uma fotografia e uma pergunta em uma história plausível sem provar que essa história aconteceu. Pode descrever um documento corretamente em um parágrafo e ainda omitir a ressalva que muda a decisão.
Use a assistência multimodal para explorar, comparar, transcrever, redigir e fazer perguntas. Quando o resultado afetar saúde, dinheiro, direitos, emprego, educação ou um registro público, volte ao material original e tome uma decisão humana sobre a afirmação.
Cinco perguntas a fazer antes de confiar no Gemini
1. O que o sistema realmente recebeu?
Liste o prompt, os arquivos, as imagens, os áudios, os links e o contexto da conta. Verifique se o sistema viu o item completo ou apenas uma representação, um trecho ou o texto extraído.
2. De onde veio a resposta?
Separe o que foi lido em seu material, o que foi recuperado de outro lugar e o que foi gerado a partir de um padrão aprendido. Abra a fonte e verifique a frase que importa.
3. O que mudou entre a entrada e a saída?
Registre a transcrição, o recorte, o OCR, o resumo, a tradução, a classificação e outras transformações. Cada etapa pode remover contexto ao mesmo tempo que torna a resposta final mais fácil de ler.
4. Quais configurações padrão moldam o resultado?
O modelo do Google, a classificação da busca, as configurações da conta, as regras de segurança e os serviços conectados influenciam o que se torna visível. Pergunte o que o sistema teria feito sem sua correção e o que ele não pode mostrar.
5. Quem assume a responsabilidade pela afirmação final?
Designe uma pessoa para aprovar a declaração antes de sua publicação ou uso. Um assistente multimodal pode acelerar a inspeção; não pode assumir responsabilidade por uma decisão tomada a partir de sua saída.
O ecossistema do Google faz parte da resposta
O Gemini não funciona em uma sala vazia. Ele pode estar ao lado de buscas, documentos, dispositivos, contas e outros serviços. Essa integração pode facilitar o acesso a um contexto útil, mas também dificultar a percepção dos limites entre seu material, os dados da plataforma e a interpretação do modelo.
A conveniência não deveria exigir a perda do registro de como uma decisão foi tomada. Mantenha juntos a entrada original, as fontes recuperadas, a resposta gerada e as edições humanas. Se o serviço mudar um modelo ou uma permissão, seu relato da decisão deve continuar portável.
A solução é contexto visível e controle humano
Um sistema multimodal responsável deveria mostrar o que recebeu, o que usou, o que transformou e onde ainda há incerteza. As pessoas deveriam poder corrigir uma resposta, preservar a fonte e levar seu trabalho consigo. O assistente deve facilitar a inspeção do caminho entre evidência e afirmação, não substituir esse caminho por uma frase bem-acabada.
Isso se conecta ao argumento mais amplo por trás do trabalho de Lu Heng. Seu guia sobre IA generativa explica por que uma instrução não equivale a compreensão. Sua Nota sobre camadas da realidade e poder simbólico convida os leitores a separar o que existe dos rótulos e narrativas sobrepostos a isso. Sistemas multimodais tornam essa separação mais urgente porque podem associar uma narrativa convincente a mais tipos de material.
Por que essa distinção importa agora
Imagens, gravações e documentos estão chegando às interfaces de IA mais depressa do que a maioria das pessoas consegue aprender a examinar as transformações. Se uma resposta fluente se tornar a única versão a circular, o operador do sistema ganha influência sobre quais evidências sobrevivem, qual contexto desaparece e qual interpretação parece óbvia.
A pergunta importante não é se o Gemini vence uma comparação de recursos. É se as pessoas podem usar um sistema de IA integrado e, ao mesmo tempo, preservar o direito de ver a fonte, compreender a transformação, contestar o resultado e tomar por conta própria a decisão final.
Comece com um arquivo e uma afirmação verificável
Forneça ao assistente um documento, uma imagem ou uma gravação e faça uma pergunta restrita. Mantenha o original ao lado da resposta. Marque o que está diretamente presente, o que foi inferido e o que exige outra fonte. Se a ferramenta ajudar você a enxergar com mais clareza, mantenha-a no processo. Se apenas facilitar a repetição de uma história sem respaldo, pare antes que essa história se transforme no registro.
Deixe sua opinião
Entre com uma conta existente para comentar.