
Edge Computing und Cloud Computing im Vergleich
Am Beispiel eines Gewächshaussensors: Welche Aufgaben gehören in die Nähe des Geschehens, welche profitieren von gemeinsam genutzten Ressourcen – und wie ergänzen sich Edge und Cloud?
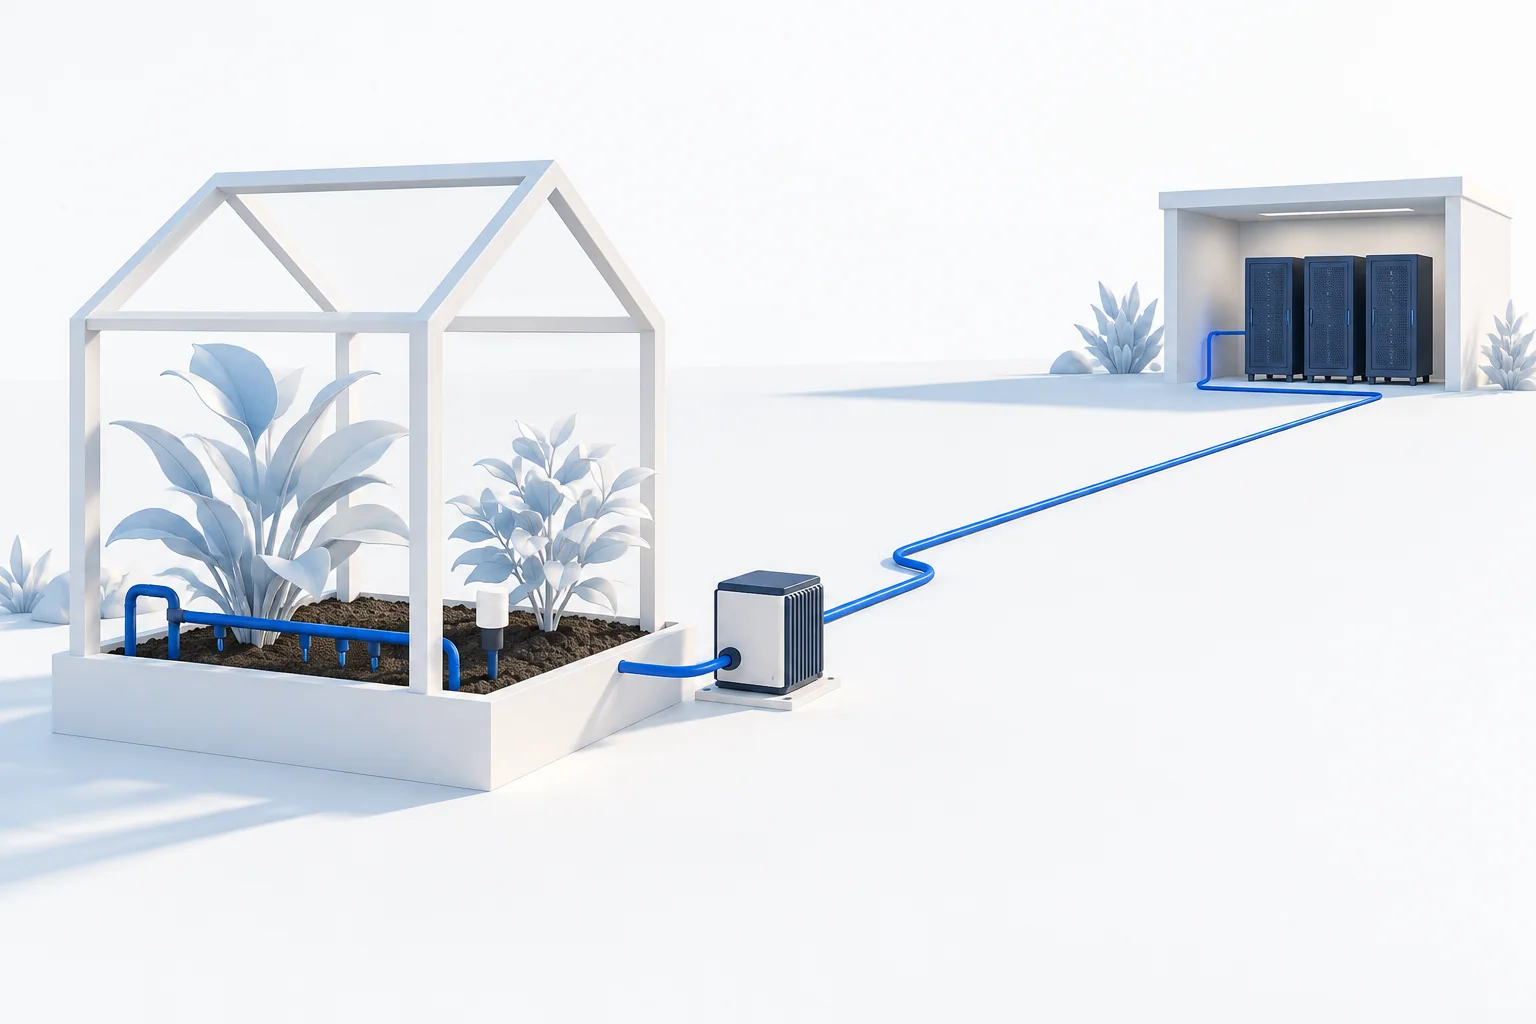
In einem Gewächshaus kann die Entscheidung über die Bewässerung vor Ort fallen, während Messwerte über längere Zeiträume zur Analyse an einen anderen Standort übermittelt werden. Die beiden Aufgaben müssen nicht miteinander konkurrieren.
Stellen Sie sich ein Gewächshaus vor, in dem die Pflanzen bewässert werden, sobald der Boden zu trocken wird. Eine Aufgabe erfordert eine schnelle Reaktion direkt bei den Pflanzen. Eine andere vergleicht Messwerte aus mehreren Monaten und mehreren Gewächshäusern. Diese Aufgaben müssen nicht auf demselben Computer ausgeführt werden.
Edge beschreibt räumliche Nähe, Cloud ein Dienstleistungsmodell
Beim Edge Computing findet ein Teil der Datenverarbeitung in der Nähe der Menschen, Geräte oder Vorgänge statt, bei denen die Daten entstehen. Das kann eine Steuerung im Gewächshaus sein, ein kleiner lokaler Server oder Technik in einer nahe gelegenen Netzwerkeinrichtung.
Beim Cloud Computing werden Rechenressourcen als Dienstleistung bereitgestellt. Diese Ressourcen können sich in einem großen Rechenzentrum befinden, eine Cloud-Plattform kann sich aber auch auf nahe gelegene Standorte erstrecken. Edge und Cloud schließen sich daher nicht gegenseitig aus: Ein System kann beides nutzen.
Die Arbeiten des ETSI zum Edge Computing umfassen den Einsatz vor Ort und am Netzwerkrand, einschließlich der Zusammenarbeit mit Cloud-Anbietern. Wenn Ihnen die Dienstleistungsmodelle noch nicht vertraut sind, beginnen Sie mit der Einführung in Cloud Computing.
Die unmittelbare Reaktion gehört in die Nähe des Geschehens
In unserem Gewächshaus könnte eine lokale Steuerung den Sensor auslesen und ein Ventil betätigen, ohne jede Entscheidung an einen entfernten Server weiterzureichen. Ein kürzerer Weg kann die Verzögerung im Netzwerk verringern. Werden Messwerte vor Ort gefiltert oder zusammengefasst, lässt sich auch die Datenmenge reduzieren, die an andere Standorte übertragen wird.
Dieser Vorteil ergibt sich aus dem Aufbau der Anwendung. Ein Gerät in der Nähe, das für jede Entscheidung weiterhin einen entfernten Dienst benötigt, kann bei einem Verbindungsausfall nicht dieselbe Funktion aufrechterhalten. Neben der Entfernung sind auch die lokale Verarbeitungskapazität, die Software und das Verhalten bei Ausfällen entscheidend.
Gemeinsam genutzte Kapazitäten für den größeren Überblick einsetzen
Ein Cloud-Dienst könnte Messwerte aus vielen Gewächshäusern zusammenführen, ihren Verlauf speichern und die Wachstumsbedingungen über eine Saison hinweg vergleichen. Diese Aufgaben können von gemeinsam genutzten Speicher- und Rechenressourcen profitieren, ohne dass diese neben jeder Pflanze stehen müssen.
Bei Geschwindigkeit und Kosten gibt es keinen allgemeingültigen Sieger. Übertragungswege im Netzwerk, Wartezeiten und die Berechnung selbst tragen alle zur Antwortzeit bei. Ein gut angebundener Cloud-Dienst kann schneller sein als ein überlastetes lokales Gerät; eine schnelle Prüfung vor Ort kann einen unnötigen Übertragungsweg ersparen.
So lässt sich die Arbeit sinnvoll aufteilen
- Reaktionszeit: Welche Entscheidung muss schnell fallen, und wie lange kann der Nutzer oder das Gerät warten?
- Verbindungsausfall: Was soll lokal weiterlaufen, und was kann warten, bis die Verbindung wiederhergestellt ist?
- Datenübertragung: Welche Rohdaten müssen den Standort verlassen, und würde eine Zusammenfassung genügen?
- Betriebsaufwand: Wer wartet die Geräte vor Ort, und welche Ressourcen oder Übertragungen stellt der entfernte Dienst in Rechnung?
Die Antworten können zu einem lokalen Regelkreis mit entfernter Speicherung und Analyse führen. Sie können aber auch für ein einfacheres System an einem einzigen Standort sprechen. Zusätzliche Komponenten sind nur dann sinnvoll, wenn sie der eigentlichen Aufgabe dienen.
Mehr Standorte bedeuten nicht automatisch mehr Unabhängigkeit
Eine einzelne Organisation kann Computer kontrollieren, die über viele Orte verteilt sind. Wo eine Maschine steht und wer ihre Regeln ändern darf, sind zwei unterschiedliche Fragen. Um ein System zu verstehen, muss man sowohl darauf schauen, wo die Arbeit stattfindet, als auch darauf, wer über seinen Betrieb entscheiden kann.
Diese Unterscheidung führt zur übergeordneten Frage, wer die verschiedenen Teile des Internets kontrolliert. Mehr über die Verbindung zwischen Nutzer und Rechendienst erfahren Sie im Beitrag über die wichtigsten Arten des Internetzugangs.